🍌 Edit Banana
通用内容重编辑器:让不可编辑的内容变得可编辑
突破静态格式的限制。我们的平台赋予您将固定内容转化为完全可操作资产的能力。基于SAM 3和多模态大模型,它支持高保真重建,保留原始图表的细节和逻辑关系。


立即体验!

👆 点击上方或 https://editbanana.anxin6.cn/ 在线体验 Edit Banana! 上传一张图片,即可在几秒钟内获得 可编辑的 DrawIO (XML)。 请注意: 我们的 GitHub 仓库目前落后于我们的网络服务。为了获取最新功能和性能,我们推荐使用我们的网络平台。
💬 加入微信群
欢迎加入我们的微信群讨论和交流想法!扫描下方二维码加入:

扫描加入 Edit Banana 社区
💡 如果二维码已过期,请提交一个 Issue 请求更新。
📸 效果演示
高清输入输出对比(3种典型场景)
为了展示高保真转换效果,我们提供了“原始静态格式”与“可编辑重建结果”的一对一对比。所有元素均可单独拖拽、样式化及修改。
场景1:图形转换为 DrawIO (XML, SVG)
| 示例编号 | 原始静态图表(输入 · 不可编辑) | DrawIO 重建结果(输出 · 完全可编辑) |
|---|---|---|
| 示例 1:基础流程图 |  |  |
| 示例 2:多级架构图 |  |  |
| 示例 3:技术示意图 |  |  |
| 示例 4:科学公式图 |  |  |
场景2:人机协作修改
✨ 转换亮点:
- 保留原始图表的布局逻辑、颜色匹配和元素层级
- 1:1 还原形状描边/填充和箭头样式(虚线/粗细)
- 准确文字识别,支持直接后续编辑和格式调整
- 所有元素可独立选择,支持原生 DrawIO 模板替换和布局优化
主要功能
- 高级分割:使用我们微调的 SAM 3 (Segment Anything Model 3) 进行图表元素分割。
- 固定多轮 VLM 扫描:由 多模态 LLMs (Qwen-VL/GPT-4V) 引导的提取过程。
- 文字识别:
- 本地 OCR (Tesseract) 用于文字定位;易于安装 (
pip install pytesseract+ 系统tesseract-ocr),可离线运行。 - Pix2Text 用于数学公式识别和 LaTeX 转换 ($\int f(x) dx$)。
- 裁剪引导策略:提取文字/公式区域,将高分辨率裁剪发送至公式引擎。
- 本地 OCR (Tesseract) 用于文字定位;易于安装 (
- 用户系统:
- 注册:新用户获得 10 个免费积分。
- 积分系统:按次付费模式防止资源滥用。
- 多用户并发:内置支持并发用户会话,使用 全局锁 机制确保线程安全的 GPU 访问,并使用 LRU 缓存 (Least Recently Used) 在请求间持久化图像嵌入,确保高性能和稳定性。
架构流程
- 输入:图像 (PNG/JPG/BMP/TIFF/WebP)。
- 分割 (SAM3):使用我们微调的 SAM3 mask decoder。
- 文字提取 (并行):
- 本地 OCR (Tesseract) 检测文字边界框。
- 文字/公式区域的高分辨率裁剪发送至 Pix2Text 进行 LaTeX 转换。
- DrawIO XML 生成:合并来自 SAM3 的空间数据和 OCR 结果。
项目结构
Edit-Banana/
├── config/                 # 配置文件 (复制 config.yaml.example → config.yaml)
├── flowchart_text/         # OCR & 文字提取模块 (独立入口)
│   ├── src/
│   └── main.py             # OCR 独立入口
├── input/                  # [手动] 输入图像目录
├── models/                 # [手动] 模型权重 (SAM3) 和可选 BPE 词汇
├── output/                 # [手动] 结果目录
├── sam3/                   # SAM3 库 (见安装说明:从 facebookresearch/sam3 安装)
├── sam3_service/           # SAM3 HTTP 服务 (可选,用于多进程部署)
├── scripts/
│   ├── setup_sam3.sh       # 安装 SAM3 库和将 BPE 复制到 models/
│   ├── setup_rmbg.py       # 从 ModelScope 下载 RMBG 模型到 models/rmbg/
│   └── merge_xml.py        # XML 合并工具
├── main.py                 # CLI 入口 (模块化流程)
├── server_pa.py            # FastAPI 后端服务器
└── requirements.txt       # Python 依赖
安装与设置
按照以下步骤在本地设置项目。
1. 前置条件
- Python 3.10+
- 支持 CUDA 的 GPU (强烈推荐)
2. 克隆仓库
git clone https://github.com/BIT-DataLab/Edit-Banana.git
cd Edit-Banana
3. 初始化目录结构
克隆后,必须手动创建以下 Git 忽略资源目录:
# 创建输入/输出目录
mkdir -p input
mkdir -p output
mkdir -p sam3_output
3.1 模型与资源下载 (不要提交到仓库)
以下大文件不包含在此仓库中。请自行下载并放置在下方路径。仓库使用 .gitignore 排除 models/、sam3_src/ 等。不要将这些文件提交到 Git。
| 资源 | 描述 | 目标路径 | 获取方式 |
|---|---|---|---|
| SAM3 权重 | 分割检查点 (必须是 .pt 格式) | models/sam3_ms/sam3.pt 或配置中指定 | ModelScope (推荐) 或 Hugging Face |
| BPE 词汇 | SAM3 文字编码器词汇 | models/bpe_simple_vocab_16e6.txt.gz | 运行 scripts/setup_sam3.sh 时从克隆的 sam3_src 复制;或从 facebookresearch/sam3 仓库资源获取 |
| RMBG 模型 (可选) | 图标/箭头的背景移除 | models/rmbg/model.onnx | pip install modelscope && python scripts/setup_rmbg.py 或从 ModelScope RMBG-2.0 下载 |
见下方 5. 安装 SAM3 库、6. 下载模型权重 和 可选 — RMBG 部分获取详细步骤。
4. 安装 PyTorch (SAM3 所需)
安装支持 CUDA 的 PyTorch (推荐) 或纯 CPU 版本。以 CUDA 11.8 为例:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu118
其他 CUDA 版本或 CPU,请见 pytorch.org。
5. 安装 SAM3 库和获取 BPE
本项目使用 SAM3 Python API;代码不在仓库中。详细步骤:docs/SETUP_SAM3.md。
快速路径 (在仓库根目录,已激活 venv):
bash scripts/setup_sam3.sh
这会将 facebookresearch/sam3 克隆到 sam3_src,运行 pip install -e sam3_src,并将 BPE 词汇复制到 models/bpe_simple_vocab_16e6.txt.gz。
验证:python -c "from sam3.model_builder import build_sam3_image_model; print('OK')"
6. 下载模型权重
获取 SAM 3 检查点并放置在 models/ 下:
- ModelScope (推荐,无需访问申请):modelscope.cn/models/facebook/sam3
- Hugging Face:facebook/sam3 — 需要先申请访问权限。
见 docs/SETUP_SAM3.md 获取下载命令和 config.yaml 配置。
7. 安装 Python 依赖
后端 (必需):
pip install -r requirements.txt
Tesseract (默认文字 OCR;安装 Tesseract 或 PaddleOCR 之一):在系统上安装 Tesseract 引擎。Ubuntu 示例:
sudo apt install tesseract-ocr tesseract-ocr-chi-sim
如果您使用 PaddleOCR (ocr.engine: "paddleocr"),Tesseract 是可选的但推荐作为备用。
可选 — PaddleOCR (更适合中英混合文字):使用 PaddlePaddle 3.2.x + PaddleOCR 3.x (推荐 3.2.2;3.3.0+ 有 CPU oneDNN 错误,会自动回退到 Tesseract):
pip uninstall paddleocr paddlepaddle paddlepaddle-gpu paddlex -y
pip install paddlepaddle==3.2.2 paddleocr   # CPU;避免 3.3.0 oneDNN 错误
# GPU: pip install paddlepaddle-gpu==3.2.2 paddleocr
然后在 config/config.yaml 中设置 ocr.engine: "paddleocr"。
可选 — 公式识别 (Pix2Text):用于 LaTeX 公式识别,安装:
pip install pix2text
# GPU: pip install onnxruntime-gpu
可选 — RMBG (图标/箭头的背景移除):用于 IconPictureProcessor:
- 安装运行时:
pip install onnxruntime(或onnxruntime-gpu)。 - 下载 RMBG-2.0 模型 (例如从 ModelScope) 到
models/rmbg/model.onnx:
或手动:ModelScope RMBG-2.0 — 下载pip install modelscope python scripts/setup_rmbg.pymodel.onnx到models/rmbg/。
8. 配置
- 配置文件 (首次运行前必需):
编辑cp config/config.yaml.example config/config.yamlconfig/config.yaml:设置sam3.checkpoint_path和sam3.bpe_path为您的models/路径。可选设置ocr.engine: "paddleocr"使用 PaddleOCR 进行文字识别。 - 环境变量 (可选):如果使用 API 密钥或自定义端点,请在根目录创建
.env文件。
9. 注意事项与故障排除
推荐版本
| 组件 | 版本 | 备注 |
|---|---|---|
| Python | 3.10+ | 必须与 PyTorch 和 Paddle 兼容 |
| PyTorch | 2.x + CUDA 匹配 GPU | 新 GPU (例如 Blackwell sm_120) 可能需要 cu128;或设置 sam3.device: "cpu" |
| SAM3 权重 | sam3.pt (非 safetensors 格式) | 设置 config.sam3.checkpoint_path 为例如 models/sam3_ms/sam3.pt |
| PaddleOCR | PaddlePaddle 3.2.2 + PaddleOCR 3.x | 3.3.0+ 有 CPU oneDNN 错误;流程会自动回退到 Tesseract |
| Tesseract | 系统安装 | Ubuntu: sudo apt install tesseract-ocr tesseract-ocr-chi-sim |
| RMBG | onnxruntime + models/rmbg/model.onnx | 可选;使用 scripts/setup_rmbg.py 或 ModelScope 下载 |
首次运行前
- 复制
config/config.yaml.example到config/config.yaml并设置sam3.checkpoint_path、sam3.bpe_path - 将 SAM3 权重 (例如
models/sam3_ms/sam3.pt) 和 BPE (models/bpe_simple_vocab_16e6.txt.gz) 放在models/下 - 运行
scripts/setup_sam3.sh或遵循 docs/SETUP_SAM3.md 安装 SAM3 库 - 安装 Tesseract 系统全局,或安装 PaddleOCR 并设置
ocr.engine: "paddleocr"
常见问题
- "no kernel image is available for execution on the device" — GPU 架构与 PyTorch CUDA 不匹配。在
config.yaml中设置sam3.device: "cpu"或升级 PyTorch 以匹配 CUDA 构建版本 (例如 cu128)。 - "Model file not found at .../models/rmbg/model.onnx" — RMBG 是可选的;安全忽略如果您不需要背景移除。要启用:
pip install modelscope && python scripts/setup_rmbg.py或从 ModelScope RMBG-2.0 下载model.onnx到models/rmbg/。 - "PaddleOCR inference failed…fallback to Tesseract" — Paddle/oneDNN 不兼容。使用
paddlepaddle==3.2.2+paddleocr,或设置ocr.engine: "tesseract". - "Please install PaddleOCR" / "pytesseract not installed" — 安装相应的 OCR 堆栈;对于 Tesseract 仅使用,安装系统
tesseract-ocr和pip install pytesseract。 - "Checking connectivity to the model hosters" hangs —
main.py默认设置PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK=True;如果仍然卡住,运行export PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK=True再启动。
使用方法
命令行界面 (CLI)
支持图像文件 (PNG, JPG, BMP, TIFF, WebP)。处理单个图像:
python main.py -i input/test_diagram.png
输出 XML 将保存在 output/ 目录。批量处理,将图像放入 input/ 并运行 python main.py。
本地运行与测试
-
一次性设置
git clone https://github.com/BIT-DataLab/Edit-Banana.git && cd Edit-Banana
python3 -m venv .venv && source .venv/bin/activate   # Linux/macOS; Windows: .venv\Scripts\activate
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu118   # 或 CPU 构建
pip install -r requirements.txt
sudo apt install tesseract-ocr tesseract-ocr-chi-sim   # OCR (或您操作系统的等效方案)
安装 SAM3 库 (见 安装 SAM3 库) 并下载 模型权重 + BPE。然后:
mkdir -p input output cp config/config.yaml.example config/config.yaml # 编辑 config/config.yaml: 设置 sam3.checkpoint_path 和 sam3.bpe_path 为您的 models/ 路径 -
使用 CLI 测试
# 将一张图表图像放入 input/,例如 input/test.png python main.py -i input/test.png # 输出显示在 output/<图像名>/ (DrawIO XML 和中间文件) -
可选:测试 Web API
python server_pa.py
# 在另一个终端:
curl -X POST http://localhost:8000/convert -F "file=@input/test.png"
# 或打开 http://localhost:8000/docs 并使用 /convert 端点上传文件
配置 config.yaml
在 config/config.yaml 中自定义流程行为:
- sam3: 调整分数阈值、NMS (非最大抑制) 阈值、最大迭代循环次数。
- paths: 设置输入/输出目录。
- dominant_color: 微调颜色提取灵敏度。
📌 开发路线图
| 功能模块 | 状态 | 描述 |
|---|---|---|
| 核心转换流程 | ✅ 已完成 | 分割、重建和 OCR 的完整流程 |
| 智能箭头连接 | ⚠️ 开发中 | 自动将箭头与目标形状关联 |
| DrawIO 模板适配 | 📍 计划 | 支持自定义模板导入 |
| 批量导出优化 | 📍 计划 | 批量导出到 DrawIO 文件 (.drawio) |
| 本地 LLM 适配 | 📍 计划 | 支持本地 VLM 部署,独立于 API |
🤝 贡献指南
欢迎各种形式的贡献 (代码提交、问题报告、功能建议):
- 分叉此仓库
- 创建特性分支 (
git checkout -b feature/xxx) - 提交您的更改 (
git commit -m 'feat: 添加 xxx') - 推送到分支 (
git push origin feature/xxx) - 打开 Pull Request
问题报告:Issues 功能建议:Discussions
🤩 贡献者
感谢所有为项目迭代做出贡献的开发者!
| 名称/ID | 邮箱 |
|---|---|
| Chai Chengliang | ccl@bit.edu.cn |
| Zhang Chi | zc315@bit.edu.cn |
| Deng Qiyan | |
| Rao Sijing | |
| Yi Xiangjian | |
| Li Jianhui | |
| Shen Chaoyuan | |
| Zhang Junkai | |
| Han Junyi | |
| You Zirui | |
| Xu Haochen | |
| An Minghao | |
| Yu Mingjie | |
| Yu Xinjiang | |
| Chen Zhuofan | |
| Li Xiangkun |
📄 许可证
本项目采用 Apache License 2.0 开源协议,允许商业使用和二次开发 (保留版权声明)。
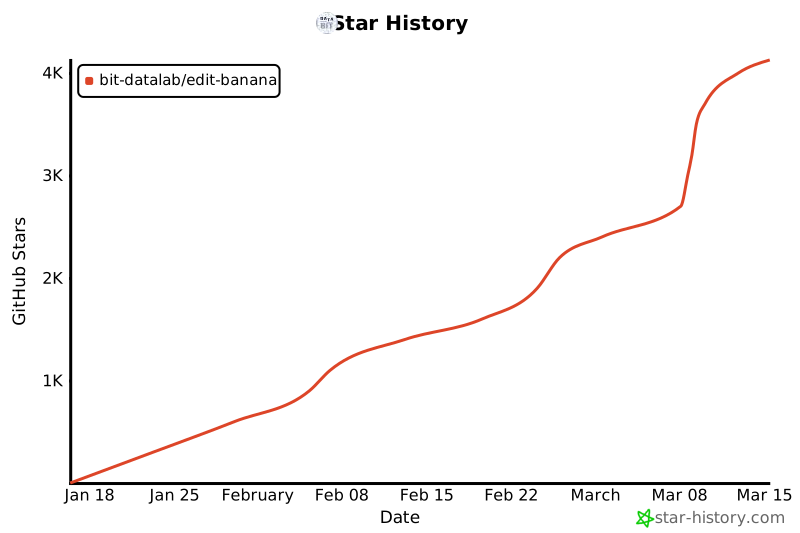
🌟 星标历史
🌟 如果这个项目对您有帮助,请星标以表达您的支持!